
万博manbext体育官网app娱乐性能再次擢升 3 倍-万博manbext体育官网(中国)官方网站登录入口
从真武 V900 到新一代磐久超节点行状器,平头哥八年来连接布局的 AI 芯片、CPU、scale up 互联、scale out 集中和存储芯片,运行被装进合并套算力系统。
作家|Cynthia
裁剪|郑玄
9 月 22 日的 2026 杭州云栖大会,平头哥少办法被完满推到了主论坛台前。
本日上昼,吴泳铭完成主旨演讲后,千问大模子、多模态模子负责东谈主挨次登场,随后即是平头哥副总裁高慧。她的演讲题目是「Agentic 期间超卓算力基石」。
平头哥带来的居品,则从一颗最新得真武 V900 芯片,一直延长到 ICN Switch 互联芯片、磐脉智能网卡、镇岳 SSD 主控、倚天 CPU 路子图,以及下一步的算、存、网全栈协同的超节点行状器。
发布「居品全家桶」地背后,是 Agentic 期间的负载变化:算力需求如故从考验为主进一步走向推理增长,应用从单轮苦求酿成连气儿的多步任务,硬件的竞争也从一颗芯片的方针扩展到统共臆测系统的协同。
01
真武V900,平头哥最新一代AI训推芯片
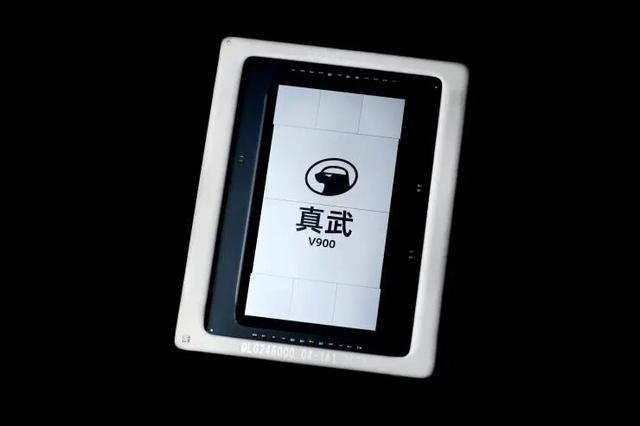
此次发布里,平头哥新一代训推一体 AI 芯片真武 V900 仍然是重量最重的居品。
这颗芯片搭载 216GB 显存,片间互联带宽达到 1200GB/s,单芯片性能是上一代真武 M890 的 3 倍,是现在中国算力性能最强的 AI 芯片。精度上,该芯片原生支握 FP8 和 FP4,可笼罩高精度考验以及低精度、超低精度推理。
按照平头哥公布的策动,V900 将在 2027 年第一季度进入量产销售。而后,2028 年 Q3,真武 J900 也将认真推出。
而此时,离上一代真武发布,其实只往日了几个月。2026 年 5 月,平头哥 M890 初次亮相。这颗芯片领有 144GB 显存和 800GB/s 片间互联带宽,性能达到上一代 810E 的 3 倍,并支握从 FP32 到 FP4 的多种数据精度。到了 V900,性能再次擢升 3 倍,显存从 144GB 加多到 216GB,互联带宽也从 800GB/s 提高到 1200GB/s。
再上前看一代,2024 年的真武 810E 也如故从早期的单一推理芯片走向训推一体,接受自研并行臆测架构和互联时间,并配套 SAIL 软件栈。
810E、M890、V900 连气儿三代居品里,平头哥一直在同期提高考验、推理、显存和低精度臆测等中枢技艺。
而背后的关节词,则恒久围绕AI 期间责任负载的变化。
举个毛糙的例子,模子进入万亿参数以后,MoE 果然成为了默许的架构给与。
如若一个几万亿参数的模子每次推理齐让全部参数参与臆测,算力蹧跶和推理资本齐会赶快高潮。因此,MoE 会把模子拆成无数内行,每个 Token 只调用其中一部分,在络续扩大模子容量的同期,把一次骨子参与臆测的参数目压下来。
这种架构缓解了臆测量,却同期把硬件压力推向了三个地方。
开端是算力。
MoE 减少了每次参与臆测的参数目,但每个子内行的参数目仍在几十万级别,Token 也依然要在很短时老实完成无数矩阵运算;进入考验阶段以后,还有反向传播、梯度更新等更重的臆测。大模子参数膨胀后,AI 芯片的臆测性能必须同步加多。这亦然平头哥往日几代真武芯片一直在擢升的技艺
算力除外,模子进入万亿参数范围后,显存也会成为新的重心。
单颗 M890 有 144GB 显存,真武 V900 则进一步擢升至 216GB。如斯一来,只需 10 多张真武 V900,即可部署一个万亿范围的大模子。
据悉,基于真武 M890 的超节点已大范围应用,并跑通了 Qwen3.8、Kimi K3 等超 2 万亿参数范围模子,让数万亿参数模子的内行并行尽量在一个超节点里面完成。
但唯一算力与显存还不够,面对数万亿参数范围的模子,任何一颗单芯片的显存容量齐显然不够。因此,模子在部署骨子时,必须拆到好多颗芯片上,然后芯片之间就会不回绝换数据。
于是,推根由此酿成臆测与数据交换不回绝替的过程:一颗芯片算完我方的子内行部分,数据速即就要交给另一颗芯片上的子内行;内行完成臆测,终局还要再次汇总。模子被拆到几十、上百张卡以后,芯片之间交换数据的速率,会径直影响统共模子能跑多快。
是以关于 Qwen3.8、Kimi K3 这么的万亿参数范围模子,几十上百张 AI 芯片只惩办了模子「装得下」的问题。它们之间的通讯速率,才实在决定了这些内行能不成高效地一谈责任。
这亦然平头哥这几年握续发力互联技艺的原因。
本年 5 月,平头哥互联芯片 ICN Switch 初次亮相,成为了阿里超节点情势算力的中枢芯片之一。
据先容,真武 V900 通过自研 ICN Switch 互联芯片连结后的超节点,具备原生内存语义和内存调和编址技艺,可已矣千卡全带宽高速互联。这意味着上千颗真武 V900 能像一颗「超等芯片」相同协同责任,为超大参数模子的考验和推理提供高隐隐、低延迟、高并发的算力。
随同算力与显存、互联的增强,真武系列的客户半径也同步束缚增长。
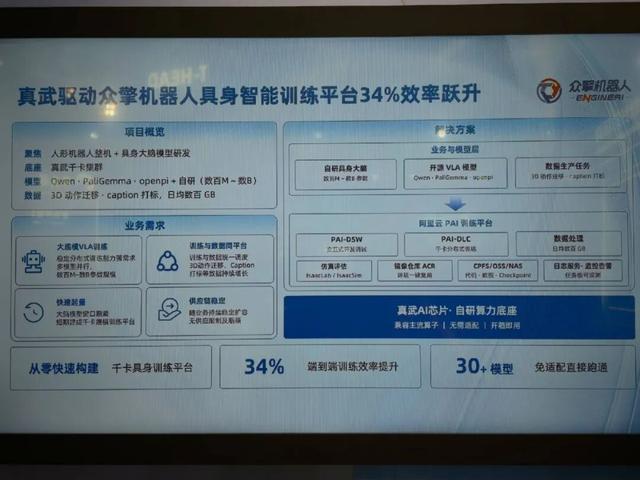
其中,在具身智能鸿沟,众擎机器东谈主基于真武搭建了千卡具身智能考验平台,笼罩模子考验、数据处理等行径,端到端考验后果擢升 34%,已有 30 多个模子不错免适配径直跑通。对需要握续处理 3D 动作转移、数据标注和大范围考验的东谈主形机器东谈主研发来说,真武如故运行进入中枢考验历程。
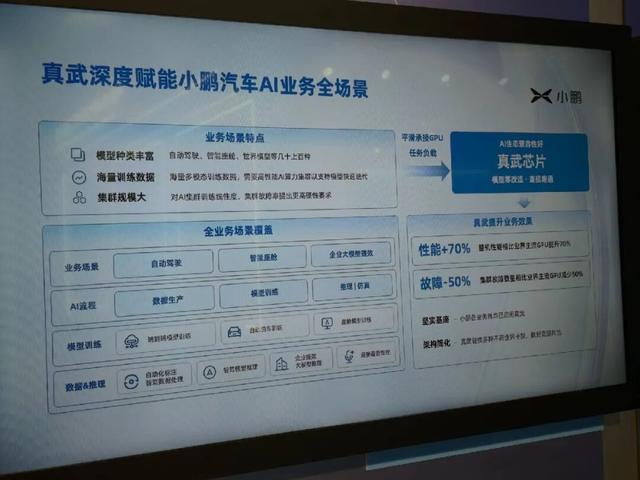
汽车场景里,小鹏则把真武用于自动驾驶、智能座舱和企业大模子等多类 AI 业务。凭据现场浮现的数据,真武整机性能比拟其对比的业界主流 GPU 擢升 70%,集群故障数目减少 50%;同期通过替换往日多种不同卡型,已矣了把部辞别布的算力资源纳入调和资源池的集结料理。
死亡现在,真武系列如故行状跨越 650 家企业客户,笼罩智驾、金融、大模子、具身智能、动力、制造等行业。
02
从一颗芯片到算存网全栈协同
在 V900 和新一代 ICN Switch 除外,平头哥此次还把磐脉智能网卡、镇岳 SSD 主控以及倚天 CPU 放进了合并张居品图里。
其中,真武承担 AI 臆测,ICN Switch 负责 AI 芯片之间的高速互联,磐脉进入行状器与数据中心集中,镇岳负责 SSD 限度,倚天则处理通用臆测。
这其中,行状器 CPU 倚天是个关节点。
在传统 AI 考验里,主要臆测集结在加快器,CPU 更多承担数据准备、苦求处理和移动。
但在 Agent 的情况截然有异。高慧现场举了一个行业筹商的例子。一个 Agent 如若要完成一份领悟,需要搜索贵府、读取文档、运行代码考据、保存中间气象,再把多路终局汇总。模子推理仅仅统共任务链的一部分,其他行径齐会握续占用 CPU。
本年 Computex 上,Intel 曾经给过一组公开测算:在前沿模子考验里,一颗 CPU 约莫不错搭配 8 颗 GPU;到了 Agentic AI 负载,CPU 密度如故向 1:1 致使更高变化。
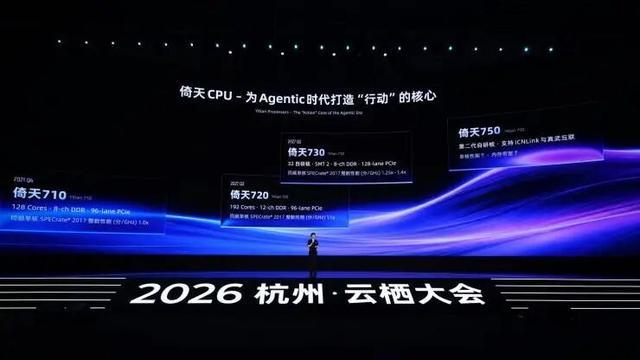
亦然因此,在云栖大会现场公布的倚天路子图中咱们不错发现,它的发展趋势,正从 AI 芯片一侧的自研技艺,束缚络续向整机中的一环真切:具体来说,平头哥将在 2027 年推出倚天 720 和 730,其中倚天 720,190 核,12 通谈 GDI,96LanePCIe,面向隐隐并发型场景;倚天 730 则将成为第一代自研高性能核,支握两路同步,多线程,128LanePCIe,单核性能跑分最高不错达到上一代的 1.4 倍,面向延迟敏锐型的场景,为 AI Head Node 提供详情趣的单核性能。畴昔还将络续推出基于第二代自研中枢的倚天 750,,这颗芯片原不错和真武 AI 芯片通过合并套高速互联体系交换数据,镌汰 CPU 与 AI 芯片之间的数据交换支出。
云栖大会现场,平头哥的智能网卡和存储主控也悉数亮相。
其中,磐脉智能网卡负责把行状器接入数据中心集中,镇岳 SSD 主控处理腹地存储。关于大模子考验和推理来说,模子、考验数据、Checkpoint 和中间终局齐需要在存储、行状器和集群之间握续流动,臆测单元除外的隐隐也会影响举座掌握率。
硬件组合完成后,还要惩办软件的配套问题。
模子里的细腻力、MoE、矩阵乘等臆测,临了齐要酿成芯片梗概推论的算子。而合并个算子,数据若何排布、使用什么精度、若何调用片上内存、若何编译,推论后果可能差好多。
以 Kimi K3 适配真武 M890 的过程为例。
基于 64 张 M890,Kimi K3 发布后,阿里云、平头哥和 Kimi 团队并莫得停在模子如故适配真武这一步,而是络续诊治软件栈和核默算子。最终已矣首 Token 时延下跌约 35%,单卡解码隐隐擢升 1.8 倍。
本年 7 月,平头哥怒放的 SAIL 软件栈在其中起到了关节性作用。在软件层面,它梗概笼罩操作系统、SDK 和接口层,同期提供驱动、性能分析和调试器具,从而保证一颗新芯片作念出来以后,本来运行在其他硬件上的模子和框架,不错尽快迁往日。
现时,SAIL 如故支握了 python、TensorFlow、vLLM、SGLang 等 260 多个主流考验和推理框架。在 Github 上,15218 个跨越 1 亿 star 的主流 AI 仓库中,SAIL 软件栈如故笼罩了跨越 96%,vLLM、SGLang 这些主流的推理框架从上游开源新版块到 SAIL 完周到量的适配,平均时分不跨越 1 周。
再往上,是云平台。等模子的用卡需求从几十张卡走向更大的集群,软件面对的问题还会再变一层。
阿里领有模子、芯片、推理平台和云的完满链条,不错针对模子已矣从芯片到云平台层面的全链路优化,权臣擢升推理后果、大幅镌汰推理资本。举例,通过算子优化和软硬件架构协同,阿里云灵骏真武超节点实例在 Agentic 推理场景中最多可已矣 1.5 倍的推感性能擢升。
到了这一步,一颗 AI 芯片才实在酿成云上的算力。
03
面向10倍算力中心,
阿里芯片、模子和云协同上风进一步放大
吴泳铭本日的演讲里,把机器智能期间的基础设施归结为三个部分:AI 模子、AI 芯片和 AI 云。
随后他给出的几组数字:
一边是模子。千问策动络续考验 5 万亿到 10 万亿参数范围的新模子。
另一边是云。吴泳铭示意,现时客户 AI 需求依然绝顶强盛,中经久需求远超供给技艺;阿里将络续插足 AI 基础设施诞生,到 2032 年,阿里云运营的大家数据中心范围宗旨跨越 20GW。这延续了阿里往日一年握续加码算力的地方。
而当算力诞生走到这个范围以后,自研芯片对阿里的意旨也会发生变化。
它不再仅仅一项讲明时间技艺的芯片业务。几十万张加快卡进入合并个云臆测体系,需要经久面对供给、资本、功耗、行状器联想、集中扩展、模子适配和软件后果。对芯片、行状器、超节点、集中、模子和推理系统进行结伴调优,提高的是统共 AI 集群的 Token 产能和后果。
但反过来从另一个角度起程来看,统共阿里体系的资源与领略,也在反哺平头哥的技艺迭代。
如若记忆往日几年的行业发展,不难发现,在 AI 期间,芯片行业迎来爆发的同期,也濒临着一个自然的辛苦:硬件与软件之间的发展代差。
一颗复杂 AI 芯片,从架构界说、RTL 联想、考据到流片,不时是以年为单元鼓吹的工程。EDA 巨头 Synopsys 浮现过一个 AI 加快器案例,18 个月完成流片如故被四肢极快的征战速率;同类名目传统上可能需要 3 到 4 年。流片之后,还要经过硅后考据、封装、良率爬坡和量产准备。
但往日三年,AI 模子从参数目到模子架构如故换了几轮时间路子。
2023 年,Qwen 公开的最大模子照旧 72B 范围的 Dense Transformer,硬件面对的是一套相对径直的矩阵臆测;2024 年 3 月,Qwen 推出首个 MoE 模子 Qwen1.5-MoE,压力散布到显存、内行路由和跨卡通讯;到 2025 年的 Qwen3,Dense 和 MoE 如故同期存在于一代模子里;2026 年的 Qwen3.8-Max 则把 Sparse MoE 络续推到 2.4 万亿总参数,每次只激活 950 亿参数,长凹凸文和推理模子又蜕变了单次苦求握续的时分和内存占用神情。
应用侧变化也在蜕变咱们对硬件的需求结构。开端的大模子应用以 Chat 为中心:用户输入一句话,模子复返一段文本,绝大部分重臆测齐留在模子里面,GPU 和内存是唯二的主角。随后,模子运行调用搜索、代码解释器、数据库和多样 API,Agent 成为新的主流,模子运行把一部单干作交给外部器具,CPU、集中的遑急性被摆上台面。
也即是说,一颗今天立项的芯片实在直范围插足使用时,它行状的模子与应用很可能如故不是立项时最主流的那一类,一朝等 MoE 如故成为主流,再决定要不要加强互联;等 Agent 如故无数进入出产环境,再再行辩论 CPU 和 AI 芯片之间的联系,时分不时如故不够了。
硬件必须能提前几年判断模子的走向,这亦然阿里体系作念芯一刹一个很独特的上风:
平头哥左手是握续变化的千问模子与 Agent 家眷,右手是相对镇定的电商、支付、舆图、办公和征战者场景,向下是实在运行这些模子的阿里云。表里部视线联结,巧合候变化的苗头刚出现,契机就如故比公开市集需求更早进入芯片和系统团队的视线。
而这种多看见的少许畴昔,自己即是硬件技艺的一部分。
*头图来源:2026 杭州云栖大会万博manbext体育官网app娱乐